deepseek-visionaryはMCPエージェントにOCRと視覚的コンテキストを追加します
Xlightのdeepseek-visionaryは、テキスト専用のAIエージェントに視覚入力を提供するMCPサーバーおよびプラグインであり、エージェントのワークフロー内での画像ベースのテキストローカリゼーションとOCRを可能にします。このツールは、DeepSeekのビジョン・ランゲージモデルをModel Context Protocolホストに接続し、埋め込まれたテキストを抽出し、下流のLLM消費のための構造化された説明を生成します。主な機能には、JSON/markdown画像説明、ハイブリッドOCRとビジョン・ランゲージ分析、そして複数ホストの互換性が含まれ、視覚処理をMCPパイプラインに統合する開発者や研究者を対象としています。
実際にどのようなタスクに使用できますか?
Visionaryは視覚資産を機械可読のテキストと説明的メタデータに変換し、エージェントが画像コンテンツに基づいて行動できるようにします。これは、UIテキストのローカリゼーション、文書の転写、言語モデル用の画像説明の生成などのタスクのために構築されています。具体的な出力には、OCRの転写と、LLMプロンプトや自動化スクリプトに直接接続できる構造化されたJSONまたはマークダウンの説明が含まれます。典型的なワークフローは、抽出されたテキストをローカリゼーションパイプラインや注釈ツールと組み合わせます。
ローカリゼーションとOCRの出力の精度はどのくらいですか?
このプロジェクトは高精度の光学文字認識を宣伝しており、そのOCRを視覚と言語のモデルの説明と組み合わせて文脈を追加します。精度は選択したバックエンドとモデルに依存します。サーバーは複数の視覚プロバイダーと自動化されたブラウザパスを通じてアクセスされるWebネイティブモデルをサポートしています。構造化された出力は、下流処理のためにクリーンなJSONまたはマークダウンを提供することでパースエラーを減少させることを目指しています。
技術的なセットアップは必要ですか?開発者のワークフローにはどのように適合しますか?
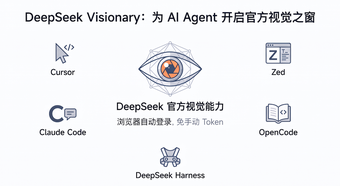
VisionaryはNode.jsサーバーコンポーネントとして実行され、MCP互換のホストと統合されるため、セットアップには開発環境が必要です。サポートされているホストには、Claude Desktop、Zed、Cursor、ネイティブプラグインとして使用されるDeepSeek Harnessが含まれます。Webネイティブの視覚アクセスのための自動セッション管理とスタンドアロンのMCPサーバーモードにより、エンジニアはホストコードを書き換えることなく、既存のエージェントパイプラインにコンポーネントを埋め込むことができます。
チームはバックエンドとデータ処理について何を考慮すべきですか?
このプロジェクトは複数のバックエンドオプションを提供しています:構成は、標準APIキーなしでWebネイティブの視覚モデルにアクセスするためにvisionary-server CLIを使用するか、ベンダーサービスの公式API資格情報に接続されることができます。Xlightはまた、主要なプロバイダーにアクセスできない場合でも画像処理を続行できるように、マルチホストフォールバックを実装しています。チームはコネクタ管理を計画し、ターゲットコンテンツタイプのために選択したバックエンドをテストする必要があります。
検査可能でコミュニティに支えられたツールを重視する開発者チームに適しています
このプロジェクトはGitHubでホストされており、MCPやDeepSeek Harnessコミュニティリストで頻繁に引用されていますので、コネクタを適応させたり、処理コードを検査したりすることを計画しているチームに適しています。実用的なヒントとして、生成されたテキストを消費するローカリゼーションパイプラインには人間のレビューを含めることをお勧めします。コミュニティの可視性を持つMCPネイティブのビジュアルブリッジが必要な開発者にとって、このプロジェクトは実用的な選択肢です。